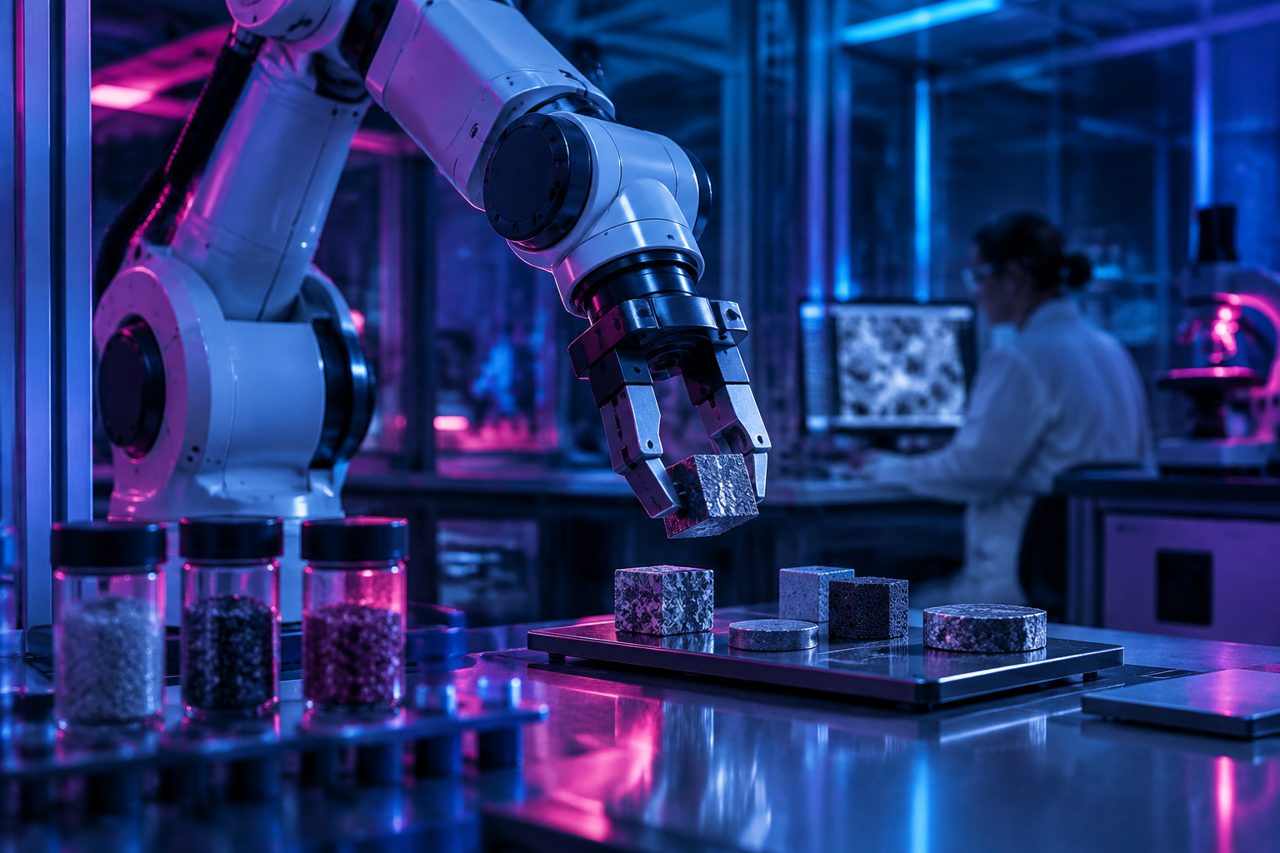
Dans le laboratoire, personne ne tient la pipette. Un bras robotisé prépare un mélange, un instrument mesure ses propriétés, puis un logiciel décide de la prochaine expérience. Cette scène existe déjà : elle incarne l’ambition des laboratoires autonomes, capables d’enchaîner hypothèses, manipulations et analyses. À l’horizon de septembre 2026, leur promesse mérite pourtant d’être formulée sans emballement : non pas découvrir à coup sûr le matériau miracle, mais apprendre davantage avec moins d’essais inutiles. Les démonstrations publiques établies, notamment celles de 2020 à 2024, permettent de comprendre cette trajectoire ; les prolongements envisagés ici restent prospectifs.
Un laboratoire qui choisit son prochain geste
L’automatisation n’a rien de neuf dans les sciences expérimentales. Depuis longtemps, des machines traitent des séries d’échantillons selon un protocole fixé à l’avance. Le laboratoire en boucle fermée ajoute une différence décisive : les résultats modifient le programme des expériences suivantes. Si une composition paraît prometteuse, le système explore ses voisines. Si une piste échoue, il peut changer de température, de dosage ou de méthode de préparation.
Imaginons la recherche d’un électrolyte pour batterie. Il faut combiner des substances, tester leur conductivité et vérifier leur stabilité. Explorer toutes les recettes devient vite irréaliste. L’apprentissage automatique sert alors à arbitrer : faut-il améliorer la meilleure formule connue ou essayer une zone mal comprise ? Des méthodes comme l’optimisation bayésienne organisent ce compromis entre exploitation et exploration, en tenant compte de l’incertitude des prédictions.
Le dispositif repose sur une chaîne complète : préparation robotisée, mesure, traitement des données, sélection d’une nouvelle expérience. Un algorithme brillant ne suffit donc pas. Il faut aussi savoir transférer une poudre sans la contaminer, nettoyer un récipient et détecter un capteur défaillant. Dans ces détails peu spectaculaires se joue une grande partie de l’autonomie réelle.
Des démonstrations concrètes, des périmètres étroits
En 2020, une équipe de l’université de Liverpool a présenté dans Nature un robot chimiste mobile, capable de circuler dans un laboratoire et de conduire une recherche sur des mélanges photocatalytiques destinés à produire de l’hydrogène. L’intérêt dépassait le bras mécanique : le système utilisait les résultats obtenus pour orienter ses essais. Il montrait qu’une boucle d’apprentissage pouvait fonctionner avec des équipements physiques, et pas seulement dans une simulation.
Autre jalon, présenté en 2023 : A-Lab, développé au Lawrence Berkeley National Laboratory avec l’université de Californie à Berkeley. Cette plateforme associait calculs, connaissances extraites de publications, apprentissage et robotique pour tenter de synthétiser des matériaux inorganiques. Elle abordait un terrain difficile : les solides, dont la formation dépend non seulement des ingrédients, mais aussi du chauffage et des étapes de transformation.
Ces travaux ont aussi rappelé l’importance du contrôle scientifique. L’identification des phases obtenues et l’interprétation de certains résultats d’A-Lab ont suscité des discussions critiques. Le point est essentiel : produire un signal compatible avec une structure attendue ne suffit pas toujours à établir qu’un matériau nouveau, pur et reproductible a été synthétisé. La découverte automatisée reste soumise aux mêmes exigences de preuve que les autres.
Prédire une structure n’est pas fabriquer un matériau
La même année, le projet GNoME de Google DeepMind a illustré la capacité de l’apprentissage automatique à proposer un vaste ensemble de structures cristallines potentiellement stables. Ce type d’outil enrichit le réservoir de candidats. Mais une stabilité calculée ne constitue ni une recette de fabrication, ni une garantie de performance dans une batterie, un panneau solaire ou un composant électronique.
Entre le fichier informatique et l’objet utile, plusieurs obstacles subsistent. Un matériau peut être difficile à obtenir, se dégrader à l’air ou nécessiter des éléments coûteux. Ses propriétés peuvent dépendre de défauts cristallins absents du modèle. La boucle fermée vaut précisément parce qu’elle confronte les prédictions à la matière : celle-ci résiste, surprend et oblige à réviser les hypothèses.
Le vrai gain : apprendre des essais, y compris ratés
La productivité ne se mesure pas seulement au nombre d’échantillons préparés. Une machine peut produire très vite des expériences redondantes. L’enjeu est plutôt le gain d’information par essai, par euro ou par quantité de matière consommée. Une expérience qui invalide proprement une hypothèse peut avoir davantage de valeur qu’une légère amélioration obtenue sans comprendre pourquoi.
Les échecs deviennent alors une ressource. Dans les publications, les recettes qui fonctionnent occupent généralement le premier plan ; les impasses restent souvent dans les cahiers de laboratoire. Une plateforme bien conçue peut enregistrer systématiquement ces résultats négatifs. Encore faut-il distinguer un échec scientifique d’un incident technique : une réaction impossible n’enseigne pas la même chose qu’une pompe bouchée.
Pour évaluer ces systèmes, quelques critères comptent davantage qu’une démonstration spectaculaire :
- Comparer les performances à une stratégie expérimentale de référence crédible.
- Intégrer le temps de préparation, de maintenance et de vérification.
- Confirmer les résultats sur de nouveaux échantillons, idéalement dans un autre laboratoire.
- Documenter les données, les incertitudes et les interventions humaines.
Le chercheur ne disparaît pas : son travail se déplace
Choisir l’objectif reste une décision humaine lourde de conséquences. Optimiser uniquement la conductivité d’un électrolyte peut conduire à négliger sa toxicité ou son inflammabilité. Chercher le catalyseur le plus actif sans considérer sa durée de vie peut produire une impasse industrielle. Le système optimise ce qu’on lui demande, pas nécessairement ce qui compte vraiment.
Les équipes doivent donc construire des objectifs multiples, fixer des limites de sécurité et décider quand interrompre une exploration. Elles enquêtent aussi sur les anomalies : résultat exceptionnel, contamination, dérive instrumentale ? L’autonomie crédible comprend la capacité de signaler un doute et de rendre la main. Elle n’exige pas de poursuivre coûte que coûte.
Du prototype à l’usine, un autre saut
Pour une entreprise, l’installation représente davantage qu’un achat de robots. Il faut relier des instruments hétérogènes, fiabiliser les logiciels et conserver la traçabilité de chaque lot. Une plateforme très performante sur une famille de réactions peut devenir peu utile lorsqu’on change de chimie. La polyvalence a un coût, tandis qu’une spécialisation trop étroite limite les usages.
Le passage à l’échelle reste également une épreuve distincte. Une recette réussie sur un petit échantillon peut changer de comportement lorsque les volumes augmentent : transferts de chaleur, agitation et impuretés ne suivent pas toujours. Dans une perspective de déploiement en 2026 et au-delà, les systèmes les plus utiles pourraient donc être ceux qui intègrent tôt les contraintes de fabrication, plutôt que ceux qui accumulent les candidats.
Et maintenant ? La trajectoire la plus plausible n’est pas celle d’un laboratoire universel sans scientifiques, mais d’îlots d’autonomie spécialisés, reliés à des équipes capables de vérifier et d’interpréter. Leur réussite se jugera sur des matériaux reproductibles, des données réutilisables et des décisions mieux informées. Les robots peuvent accélérer la recherche ; ils ne rendent pas la validation facultative. C’est même parce qu’ils multiplient les possibilités qu’une science rigoureuse devient plus précieuse.