
En octubre de 2015, un programa informático de Google llamado AlphaGo venció a Fan Hui, el doble campeón de Europa de juego de Go, por 5 victorias a 0. Fue la primera vez en la historia que un ordenador venció a un profesional en un tablero completo de Go de 19×19. Este evento no se hizo público hasta enero de 2016. AlphaGo reforzó su éxito al vencer a Lee Sedol, campeón del mundo y mejor jugador de Go del mundo desde hace una década, por 4 victorias a 1, del 8 al 15 de marzo de 2016.
Este evento ha abierto una nueva era para la inteligencia artificial, ofreciendo posibilidades que ni siquiera eran imaginables hace unos meses.
Todavía recordamos al ordenador Deep Blue de IBM venciendo al campeón del mundo de ajedrez Garry Kasparov en mayo de 1997. Entonces, ¿en qué es extraordinario el evento de este año?
Del ajedrez al Go, un cambio de escala
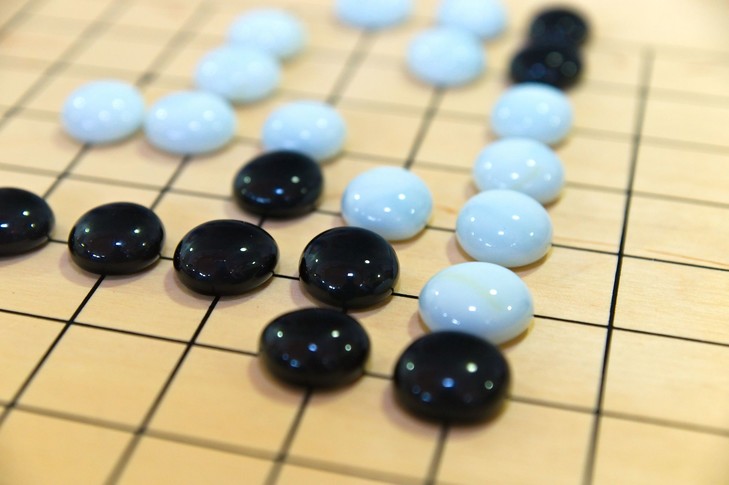 El Go, juego chino de más de 2500 años de antigüedad, se basa en la intuición, la creatividad y la estrategia. Es teóricamente imposible de analizar con un ordenador. Y con razón: el número de combinaciones posibles supera rápidamente al Gúgol (es decir, 10100).
En un tablero de ajedrez, hay 20 movimientos posibles para el primer desplazamiento. Si consideramos los 2 primeros turnos (cada jugador juega 2 movimientos), existen 20.000 combinaciones posibles.
En un tablero de Go, hay 361 posiciones posibles para una ficha. Una vez jugada la ficha, el adversario tiene 360 posibilidades de juego. Usted tendrá después 359 posibilidades para la siguiente ficha. En una partida de 2 turnos, existen cerca de 2 x 10¹⁰ posibilidades.
Se entiende bien que el Go es ya 106 veces más complejo que el ajedrez al cabo de 2 turnos. 10 turnos de Go presentan 1051 posibilidades, sabiendo que nuestra galaxia está compuesta por 1068 átomos!!!!! Haciendo hipótesis sobre el sentido común del adversario, se pueden reducir estas posibilidades (lo que se denomina poda alfa-beta). Sin embargo, es absolutamente impensable explorar todas las posibilidades, incluso por el más potente de los ordenadores.
A esto, habrá que añadir la extrema dificultad con el Go de construir una función de evaluación, que permita comparar 2 situaciones para elegir la mejor. Esto hace que ninguna máquina haya vencido jamás a un jugador profesional de Go.
Detrás de AlphaGo, DeepMind
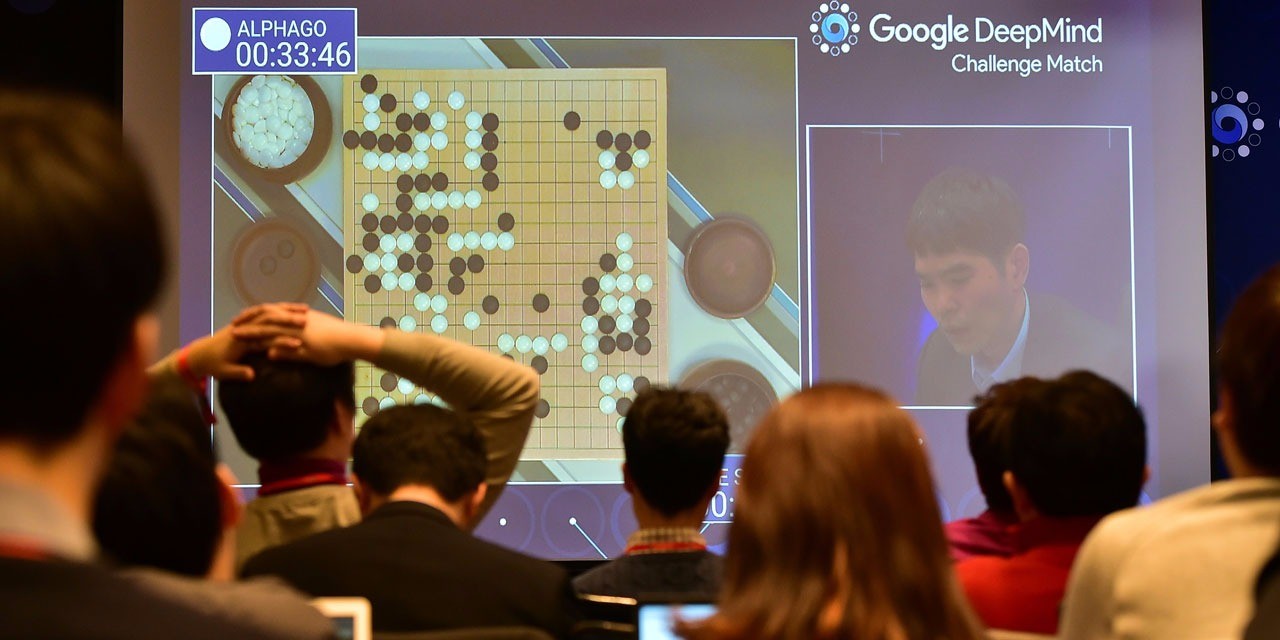 AlphaGo es el resultado de la investigación de una start-up británica: DeepMind Technologies. Creada en 2010, DeepMind Technologies fue fundada por 3 personas, incluidos 2 investigadores en inteligencia artificial: Demis Hassabis, Shane Legg y Mustafa Suleyman.
DeepMind Technologies fue adquirida por Google en enero de 2014 por 400 millones de dólares. Se trata de la mayor adquisición europea de la firma de Mountain View.
Detrás de DeepMind, el deep learning
 DeepMind Technologies explota una ciencia en pleno auge llamada deep learning o aprendizaje profundo.
En 1957, apareció el perceptrón, modelo matemático simplificado de la neurona biológica. Hacia finales de los años 80 aparecieron las redes neuronales artificiales por capas.
Yann LeCun, uno de los inventores del aprendizaje profundo y hoy director del laboratorio de Inteligencia Artificial de Facebook, había defendido su tesis en 1987. Desarrolló un programa que sirvió para leer cerca del 20% de los cheques emitidos en EE. UU.
Pero como la potencia de los ordenadores de la época no era suficiente para permitir un uso cómodo del método, este fue abandonado progresivamente en detrimento de otros enfoques. Fue retomado hacia el año 2000 con un avance fulgurante.
Detrás del deep learning, las redes neuronales
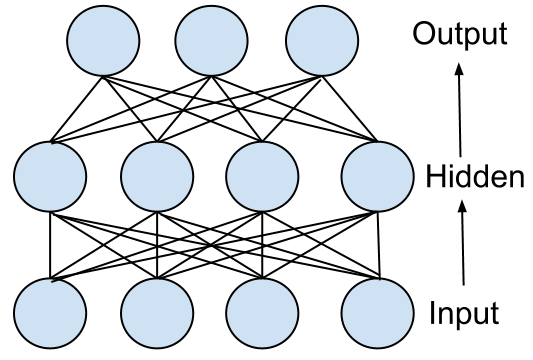 El estudio de las redes neuronales artificiales (ANN) tiene como objetivo desarrollar máquinas capaces de aprender. El aprendizaje puede ser de dos tipos: supervisado o no supervisado. En el primer caso, la máquina no tiene conocimiento previo de las reglas vinculadas al dominio aprendido. Visualiza millones de partidas ya registradas. En el segundo enfoque, la máquina juega millones de partidas contra sí misma para encontrar sus propias estrategias.
AlphaGo utiliza una combinación de estos dos enfoques, apoyados por dos redes neuronales multicapa que programa sucesivamente. Exactamente como un niño observando a su abuelo jugando al póquer, aprende sobre la marcha el valor de las cartas, las reglas del juego y la estrategia, a lo largo de las partidas. Luego se retira para jugar solo por su cuenta, para encontrar sus propias técnicas y refinar su estrategia.
En los últimos 5 años, el deep learning ha avanzado considerablemente en el plano teórico. El desarrollo de nuevos algoritmos para redes neuronales multicapa ha conducido a avances fulgurantes en diferentes campos de aplicación como la visión, el reconocimiento de voz, la biología, el análisis del ADN o los juegos.
En este último campo, el deep learning ha permitido crear máquinas capaces de analizar millones de partidas y crear sus propias estrategias.
Lee Sedol dice que la razón de su derrota es que la máquina utiliza estrategias completamente inusuales, que ningún humano habría utilizado jamás. Afirma que con el tiempo podrá adaptarse a este tipo de comportamiento y terminar por vencer a la máquina. Pero apostemos a que, como el río que se miraba en los ojos de Narciso mientras este admiraba su propio reflejo en la superficie del agua, la máquina será capaz de adaptar su propia estrategia a medida que el campeón del mundo se acostumbra a sus comportamientos: la carrera por la inteligencia entre el hombre y la máquina por la supremacía y la dominación sobre el planeta Tierra ya ha comenzado.
El deep learning y la invasión de los robots
 El campo de las máquinas autónomas y de autoaprendizaje ya genera un miedo alimentado por las películas de ciencia ficción: por primera vez en la historia de la humanidad, una máquina posee más inteligencia que el humano vivo más eficiente.
Aunque se trate —por el momento— de campos muy específicos, algunas personas como el empresario multimillonario Elon Musk o el físico Stephen Hawking alertan sobre el hecho de que un día cercano, estas máquinas podrán tomar el control de su destino y volverse incontrolables para el Hombre.


